产品咨询:4000 258 365

上一篇文章(《实践案例|数据库审计落地大型客户专有云:从“能力可用”到“价值可见”》)讲的是数据库审计怎么在大型客户的专有云里,把“看得见”做扎实——流量稳定采集、会话完整还原,并在真实负载下稳定运行。
可在“看得见”落地之后我们体会到:把行为记下来,是审计价值的第一层,在这一层之上,还得看得准、用得上。
这个方向的苗头,项目里已经看得到:为不让运营被告警淹没,项目把风险识别从“单点命中”推向“场景化分类”,并治理压缩了大量重复、误报的告警。顺着这条线索,安华金和把“智能降噪”沉淀成了产品化能力——现实中相当一部分告警,是规则把“合法的例行操作”误判成了噪音;降噪要做的,正是从这片噪音里把“该看的那几条”挑出来。
那降噪到底怎么降才“看得准”,又靠什么不掉进“越剪越空”的坑里?这背后的思路,正是本文要讲清楚的。
一、先看清:降噪真正难的是什么 一说到降噪,很多人的第一反应是“调调阈值、加几个白名单”。这套做法能缓解,但“天花板”很低——它只判断这一条请求长什么样,判断不了这次访问发生在什么业务场景里。而恰恰是业务场景,决定了一条访问该不该看。 举个例子,运维在固定维护窗口做的批量变更,和陌生账号在深夜、从异常终端碰同一批敏感表,从操作上看可能高度相似,却分属两种性质。区别不在“操作了哪些命令”,而在于三件事是否同时成立: 访问的是谁:在岗职责账号,还是来路不明的身份? 访问的目标:核心业务数据,还是外围报表? 访问的时机与场景:正常维护窗口、惯常网段,还是非工作时间、跨区访问? 这三件事拼在一起,才构成“这条访问合不合理”的答案。降噪的分水岭就在于此——能否从“匹配特征”走向“结合身份、资产敏感度与场景综合判断”。
二、搭漏斗:分层递进的智能降噪体系 把上面这层道理落地,我们摸索出的办法,不是堆更细的规则、调更大的阈值,而是以安知智能体(LLM+Agent)为核心引擎,把“这一条要不要看”从浅到深分成四层。每一层只处理它能处理好的那批,层层收窄,直到剩下真正需要人判断的那一小部分。 第一层,看告警本身:境外来源地址、高频脚本访问、单源多账号,这类特征本身已说明问题,由规则引擎直接判定过滤,不消耗模型算力。 第二层,看它与规则本意的关系:高危规则为防遗漏往往口径偏宽,例行批量作业常被误纳。由大模型解析规则的配置、防意与边界,剔除这类“形态吻合、实质不属”的命中。 第三层,看它在行为序列里的位置:同一账号若数日内持续逼近同一批高敏感数据,“偶然”便难以成立。这一层将告警连同周边行为整体交给大模型,必要时反向向数据库安全审计/应用安全审计调取更长跨度的上下文。 第四层,机器看不透的交给人工:个案由分析师补充信息、复核裁定;人工复核的结论会沉淀为可复用的判据,成为后续同类研判的重要依据。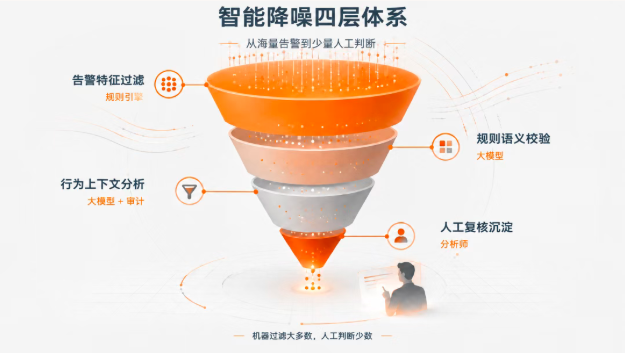
三、抓关键:从“逐条研判”到“日常运营” 筛后留下的风险若散落各处、需逐条翻阅,注意力仍会淹没在反复辨认里,研判工作台要解的就是这一步——把分散的风险收拢到一处,集中研判。 基于安知智能体,系统先给每一条留下的风险一个先行判断并附置信度,于是运营的判断,从“穷举每一条”转为“核验被指出的关键少数”,人力落在真正的分界处,而非逐条确认上。当知识与判据演进,积压的存量还可循新标尺批量重跑,判断不会因知识更新而失效。 让该看的风险被可靠地看见,也被可靠地判断——这是降噪走向“日常可运营”的重要一环。
四、筑底座:事实知识与研判经验的持续沉淀 漏斗在收敛的同时也在做取舍——哪些该留下、哪些只是噪声,直接决定了判断的“质”。而要让这份“质”站得住脚,靠的不只是漏斗本身,还有它背后的两类知识。 一是事实知识库,让 AI 认得出“正在看的是谁、是什么”。这块资产属于哪套系统、敏不敏感,这个IP/账号是什么角色——这些底料不写在任何规则里,却决定AI能否看懂一次访问的意图。底料足则判得准,缺料它只能偏保守,把不违规的正常业务也送进人判。 二是研判知识库,回答“这类情形过去怎么定性”。它不来自上线前那一纸规则,而来自运营一次一次核实后沉淀的判断。
五、见价值:降噪对审计的反哺 降噪不是一次性的过滤,它长期的价值在于持续反哺审计本身: 一是照出规则自身的缺陷。重复命中大量暴露之处,往往就是规则写得过宽、白名单没真正生效的地方——降噪跑出来的复盘能把它照出来,让人把规则调得更贴合真实风险。 二是让团队敢把规则开得更全。 从前顾虑“规则一开多,告警就把运营淹了”,如今知道告警会被层层收窄,反而敢把更多业务系统和高危场景纳入审计——降噪不是把灯调暗,而是让你敢把灯开得更亮、照得更远。 这也呼应了我们上一篇文章末尾说的那句——数据库审计真正的价值,不在“记下来了”,而在“关键时靠得住”。而“靠得住”,既意味着关键记录一条不少,也意味着那些干扰人的海量重复,不再挡在用户和真风险之间。